
Praca z relacyjnymi bazami danych jest nieodłącznym elementem tworzenia aplikacji w Javie. Ręczne przygotowywanie zapytań SQL i mapowanie wyników na obiekty bywa jednak czasochłonne. Z pomocą przychodzi Hibernate – jeden z najpopularniejszych frameworków ORM, który automatyzuje komunikację aplikacji z bazą danych.
W tym artykule wyjaśnię, jak działa Hibernate, jak mapować encje na tabele oraz wykonywać podstawowe operacje na danych.
Czym jest ORM?
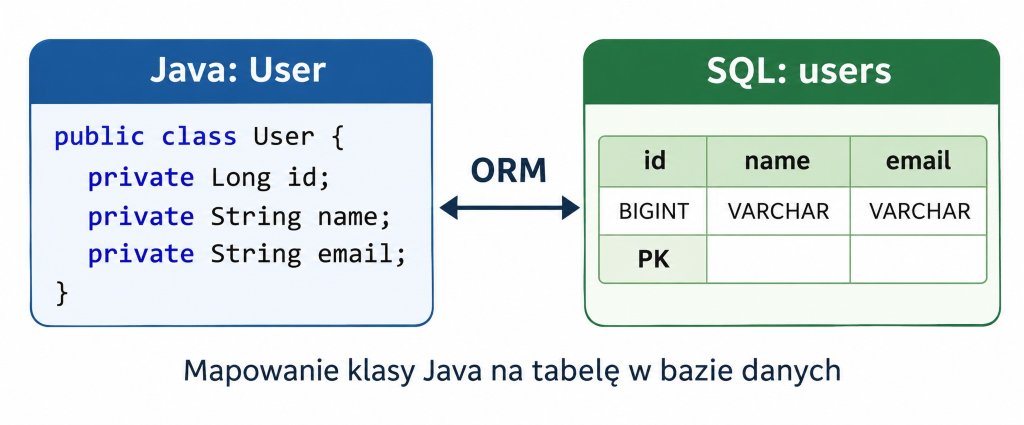
ORM (Object-Relational Mapping), czyli mapowanie obiektowo-relacyjne, to technika programistyczna umożliwiająca odwzorowanie danych przechowywanych w relacyjnej bazie danych na obiekty wykorzystywane w aplikacji.
W tradycyjnym podejściu komunikacja z bazą danych wymaga pisania zapytań SQL, wykonywania ich za pomocą mechanizmów takich jak JDBC, a następnie ręcznego przekształcania otrzymanych wyników na obiekty Javy.
ORM upraszcza ten proces, umożliwiając programiście operowanie na obiektach zamiast bezpośredniego zarządzania zapytaniami SQL. Framework ORM odpowiada za mapowanie obiektów na tabele, wykonywanie odpowiednich operacji na bazie danych oraz przekształcanie wyników zapytań na obiekty.
| Model obiektowy (Java) | Model relacyjny (SQL) |
|---|---|
| Klasa | Tabela |
| Obiekt | Wiersz tabeli |
| Pole klasy | Kolumna tabeli |
| Identyfikator obiektu | Klucz główny |
| Referencja do innego obiektu | Relacja oparta na kluczu obcym |
Zalety ORM
Najważniejszą zaletą ORM jest ograniczenie ilości powtarzalnego kodu potrzebnego do komunikacji z bazą danych. Do pozostałych korzyści należą:
- Mniejsza ilość kodu SQL – podstawowe operacje CRUD można wykonywać na obiektach.
- Łatwiejsze zarządzanie relacjami – ORM umożliwia odwzorowanie relacji między tabelami na powiązania między obiektami.
- Niezależność od konkretnej bazy danych – frameworki ORM oferują mechanizmy obsługi różnych dialektów SQL, ułatwiając zmianę silnika bazy danych.
- Integracja z programowaniem obiektowym – logika aplikacji może operować na encjach i ich relacjach zamiast na wynikach zapytań SQL.
Wady ORM
ORM nie jest jednak rozwiązaniem pozbawionym ograniczeń. Automatyzacja komunikacji z bazą danych może prowadzić do problemów, szczególnie gdy programista nie rozumie mechanizmów działania frameworka.
Najczęściej wymieniane wady to:
- Dodatkowa warstwa abstrakcji – utrudnia analizowanie operacji rzeczywiście wykonywanych na bazie danych.
- Problemy z wydajnością – niewłaściwe mapowanie encji lub pobieranie danych może powodować wykonywanie nadmiernej liczby zapytań SQL.
- Znajomość frameworków ORM – efektywne korzystanie z ORM wymaga zrozumienia zarządzania encjami, transakcji i strategii pobierania danych.
- Mniejsza kontrola nad zapytaniami – przy złożonych operacjach konieczne może być wykorzystanie natywnego SQL.
Hibernate jako implementacja ORM
Hibernate to jeden z najpopularniejszych frameworków ORM (Object-Relational Mapping) wykorzystywanych w ekosystemie Javy. Hibernate obsługuje popularne relacyjne bazy danych, takie jak PostgreSQL, MySQL, Oracle czy Microsoft SQL Server. Co istotne, wykorzystuje odpowiednie dialekty SQL, pozwalające uwzględnić różnice pomiędzy poszczególnymi silnikami baz danych.
JDBC, JPA i Hibernate – czym się różnią?
Najważniejsza różnica polega na tym, że JPA (Java Persistence API) definiuje zasady i interfejsy, natomiast Hibernate dostarcza ich konkretną implementację. W praktyce oznacza to, że aplikacja może korzystać ze standardowego API Jakarta Persistence, podczas gdy Hibernate odpowiada za faktyczne wykonywanie operacji na bazie danych.
Z koleji JDBC (Java Database Connectivity) umożliwia komunikację z relacyjnymi bazami danych. Programista korzystając z natywnych zapytań bezpośrednio przez JDBC samodzielnie przygotowuje zapytania SQL, przekazuje parametry i przekształca wyniki zapytań na obiekty. Więcej możesz się dowiedzieć z lekcji o JDBC.
Czy Hibernate zastępuje JDBC?
Nie. Hibernate korzysta z JDBC jako warstwy komunikacji z relacyjną bazą danych. Różnica polega na tym, że ukrywa przed programistą wiele szczegółów związanych z obsługą połączeń, wykonywaniem zapytań SQL i mapowaniem wyników na obiekty.
W uproszczeniu komunikacja wygląda następująco:
Aplikacja Java → Hibernate → JDBC → Baza danych
Architektura Hibernate
Architektura Hibernate opiera się na kilku kluczowych komponentach, które odpowiadają za zarządzanie encjami, wykonywanie operacji na bazie danych oraz kontrolowanie ich cyklu życia.
Hibernate pełni rolę warstwy pośredniczącej pomiędzy aplikacją Java a relacyjną bazą danych. Programista operuje na obiektach, natomiast framework zajmuje się ich mapowaniem, generowaniem odpowiednich instrukcji SQL oraz komunikacją z bazą danych za pośrednictwem JDBC.
Do najważniejszych elementów architektury Hibernate należą:
- SessionFactory – fabryka sesji odpowiedzialna za konfigurację i udostępnianie instancji
Session. - Session – główny interfejs Hibernate umożliwiający wykonywanie operacji na encjach.
- Persistence Context – kontekst przechowujący i śledzący encje zarządzane przez Hibernate.
- Transaction – mechanizm wyznaczający granice transakcji bazodanowych.
SessionFactory
SessionFactory jest jednym z najważniejszych komponentów Hibernate. Odpowiada za tworzenie instancji Session oraz przechowywanie informacji o mapowaniu encji na struktury relacyjnej bazy danych.
Do jego najważniejszych cech należą:
- Jest thread-safe, co oznacza, że może być bezpiecznie współdzielony pomiędzy wieloma wątkami.
- Jego utworzenie jest kosztowną operacją, dlatego zazwyczaj dla jednej bazy danych tworzy się pojedynczą instancję.
- Przechowuje metadane dotyczące mapowania encji.
- Zarządza współdzielonymi usługami Hibernate, w tym mechanizmami cache drugiego poziomu, jeśli zostały skonfigurowane.
W praktyce SessionFactory jest tworzony podczas uruchamiania aplikacji i wykorzystywany przez cały okres jej działania.
Session
Session reprezentuje jednostkę pracy z bazą danych (Unit of Work). Jest to podstawowy interfejs natywnego API Hibernate, pozwalający między innymi na zapisywanie, pobieranie, aktualizowanie i usuwanie encji.
W przeciwieństwie do SessionFactory, obiekt Session:
- Nie jest thread-safe i nie powinien być współdzielony między wątkami.
- Jest przeznaczony do krótkotrwałego użycia.
- Utrzymuje własny
Persistence Context. - Koordynuje operacje wykonywane na encjach i ich synchronizację z bazą danych.
Przykład wykorzystania sesji:
try (Session session = sessionFactory.openSession()) {
    User user = session.find(User.class, 1L);
    System.out.println(user.getName());
}
Persistence Context
Persistence Context (kontekst persystencji) to mechanizm Hibernate odpowiedzialny za zarządzanie stanem encji podczas pracy z bazą danych. Przechowuje referencje do zarządzanych obiektów, śledzi ich zmiany oraz umożliwia synchronizację ich stanu z bazą danych.
W natywnym API Hibernate kontekst persystencji jest powiązany z obiektem Session, który tworzymy za pomocą SessionFactory.
Każda nowa sesja utworzona przez sessionFactory.openSession() posiada własny Persistence Context. Oznacza to, że obiekty zarządzane w jednej sesji nie są automatycznie współdzielone z innymi sesjami.
Do najważniejszych zadań Persistence Context należą:
- Zarządzanie encjami – przechowywanie i kontrolowanie obiektów powiązanych z rekordami w bazie danych.
- First-Level Cache – przechowywanie encji w pamięci sesji, co pozwala ograniczyć liczbę zapytań SQL.
- Dirty Checking – automatyczne wykrywanie zmian w zarządzanych encjach.
- Synchronizacja z bazą danych – przekazywanie zmian do bazy podczas operacji
flush().
Transaction
Ostatnim istotnym elementem architektury Hibernate jest mechanizm transakcji.
Transakcja pozwala traktować zestaw operacji na bazie danych jako jedną logiczną całość. Jeśli wszystkie operacje zakończą się pomyślnie, zmiany mogą zostać zatwierdzone za pomocą commit(). W przypadku błędu możliwe jest wycofanie zmian poprzez rollback().
EntityManager
Alternatywą do używania Session jest korzystanie z mechanizmu dostarczanego przez Jakarta Persistence, czyli EntityManager. Nie będę omawiał tutaj tej technologii, natomiast działa ona analogicznie to wspomnianego wcześniej SessionFactory.
Jak współpracują ze sobą komponenty Hibernate?
Cały proces można przedstawić w kilku krokach:
- Podczas uruchamiania aplikacji Hibernate inicjalizuje
SessionFactory, wykorzystując konfigurację oraz informacje o mapowaniu encji (tabeli). - Aplikacja uzyskuje dostęp do
Session, które pozwala na wykonywanie operacji na bazie. Persistence Contextprzechowuje pobraną encję i pozwala Hibernate śledzić jej stan.- Hibernate na podstawie mapowania encji i wykonywanych operacji przygotowuje odpowiednie instrukcje SQL.
- Komunikacja z relacyjną bazą danych odbywa się za pośrednictwem JDBC.
- Hibernate synchronizuje zmiany w encjach z bazą danych, a zatwierdzenie transakcji (
commit) powoduje trwałe zapisanie tych zmian.
Mapowanie encji na tabele
Jednym z podstawowych mechanizmów Hibernate jest mapowanie obiektowo-relacyjne, które pozwala powiązać klasy Javy z tabelami w relacyjnej bazie danych. Dzięki temu programista może wykonywać operacje na obiektach, a Hibernate odpowiada za odwzorowanie ich stanu na odpowiednie rekordy w bazie.
Mapowanie encji realizowane jest najczęściej za pomocą adnotacji z pakietu jakarta.persistence, które określają między innymi nazwę tabeli, kolumny, identyfikator encji oraz sposób generowania klucza głównego.
Podstawowe adnotacje mapowania
Do najważniejszych adnotacji należą:
| Adnotacja | Zastosowanie |
|---|---|
@Entity | Oznacza klasę jako encję (wymagane). |
@Table | Określa tabelę, z którą powiązana jest encja. |
@Id | Wskazuje pole będące identyfikatorem encji (wymagane). |
@GeneratedValue | Definiuje sposób generowania identyfikatora. |
@Column | Pozwala skonfigurować mapowanie pola na kolumnę. |
@Transient | Wyklucza pole z mapowania do bazy danych. |
Przykładowa encja:
import jakarta.persistence.*;

@Entity
@Table(name = "users")
public class User {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @Column(name = "username", nullable = false, length = 100)
    private String name;

    @Column(name = "email", unique = true, nullable = false)
    private String email;

    @Transient
    private String temporaryToken;

    protected User() {
    }

    // Gettery i settery
}
W powyższym przykładzie klasa User została powiązana z tabelą users, a jej pola odwzorowano na odpowiednie kolumny.
Strategie generowania identyfikatorów
Hibernate obsługuje kilka strategii generowania kluczy głównych, które można określić za pomocą adnotacji @GeneratedValue.
| Strategia | Charakterystyka |
|---|---|
IDENTITY | Wykorzystuje mechanizm automatycznego generowania identyfikatorów przez bazę danych. |
SEQUENCE | Pobiera identyfikatory z sekwencji bazodanowej. |
TABLE | Wykorzystuje dodatkową tabelę do przechowywania i generowania identyfikatorów. |
AUTO | Pozwala dostawcy JPA wybrać odpowiednią strategię. |
UUID | Generuje identyfikatory UUID. |
Dobór strategii zależy między innymi od wykorzystywanej bazy danych oraz wymagań aplikacji.
Mapowanie relacji między encjami
Oprócz mapowania pojedynczych pól Hibernate umożliwia również odwzorowanie relacji pomiędzy tabelami na powiązania między obiektami Javy.
W tym celu wykorzystywane są cztery podstawowe adnotacje:
| Adnotacja | Rodzaj relacji |
|---|---|
@OneToOne | Jeden do jednego, np. użytkownik i profil. |
@OneToMany | Jeden do wielu, np. użytkownik i jego zamówienia. |
@ManyToOne | Wiele do jednego, np. wiele zamówień przypisanych do użytkownika. |
@ManyToMany | Wiele do wielu, np. studenci i kursy. |
Odwzorowanie relacji jeden do wielu
Przyjrzyjmy się relacji OneToMany na przykładzie użytkownika, który może posiadać wiele zamówień.
Encja User:
@Entity
@Table(name = "users")
public class User {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @OneToMany(mappedBy = "user")
    private List<Order> orders = new ArrayList<>();

    // Gettery i settery
}
Encja Order:
@Entity
@Table(name = "orders")
public class Order {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @ManyToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "user_id")
    private User user;

    // Gettery i settery
}
W przedstawionym przykładzie:
@OneToManyokreśla, że jeden użytkownik może posiadać wiele zamówień.mappedBy = "user"wskazuje pole w encjiOrder, które zarządza relacją.@ManyToOneokreśla, że wiele zamówień może być przypisanych do jednego użytkownika.@JoinColumn(name = "user_id")wskazuje kolumnę zawierającą klucz obcy w tabeliorders.
Hibernate obsługuje zarówno relacje jednokierunkowe (unidirectional), jak i dwukierunkowe (bidirectional). W tym przypadku masz zastosowane mapowanie dwukierunkowe z racji, że jest ono rekomendowane. Dzięki temu możesz nawigować po relacji w obu kierunkach
Relacja OneToOne (jeden do jednego)
Relacja @OneToOne oznacza, że jeden rekord w tabeli jest powiązany z maksymalnie jednym rekordem w drugiej tabeli.
Przykładem może być użytkownik (User) oraz jego profil (UserProfile). Każdy użytkownik posiada maksymalnie jeden profil, a każdy profil należy do jednego użytkownika.
@Entity
public class UserProfile {

    @Id
    @GeneratedValue
    private Long id;

    @OneToOne(fetch = FetchType.LAZY)
    @JoinColumn(name = "user_id", unique = true)
    private User user;
}
Preferowane jest tu mapowanie jednokierunkowe.
Relacja ManyToMany (wiele do wielu)
Relacja @ManyToMany oznacza, że wiele rekordów jednej tabeli może być powiązanych z wieloma rekordami drugiej tabeli.
Przykładem może być system edukacyjny, w którym jeden student (Student) może uczestniczyć w wielu kursach (Course), a jeden kurs może mieć wielu studentów.
W relacyjnej bazie danych taka zależność wymaga zastosowania tabeli pośredniczącej (Join Table), która przechowuje powiązania między rekordami.
Przykład mapowania dwukierunkowego:
Encja Student:
@Entity
@Table(name = "students")
public class Student {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @ManyToMany
    @JoinTable(
        name = "student_courses",
        joinColumns = @JoinColumn(name = "student_id"),
        inverseJoinColumns = @JoinColumn(name = "course_id")
    )
    private Set<Course> courses = new HashSet<>();

    // Gettery i settery
}
Encja Course:
@Entity
@Table(name = "courses")
public class Course {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @ManyToMany(mappedBy = "courses")
    private Set<Student> students = new HashSet<>();

    // Gettery i settery
}
W powyższym przykładzie:
@ManyToManydefiniuje relację wiele do wielu.@JoinTableokreśla tabelę pośredniczącąstudent_courses.joinColumnswskazuje kolumnęstudent_id, która przechowuje klucz obcy do tabelistudents.inverseJoinColumnswskazuje kolumnęcourse_id, która przechowuje klucz obcy do tabelicourses.mappedBy = "courses"oznacza, że encjaCoursejest odwrotną stroną relacji, a właścicielem jestStudent.
Mapowanie to można też wykonać w inny sposób, np. poprzez encje pośredniczącą.
Cykl życia encji w Hibernate
Każda encja zarządzana przez Hibernate posiada określony stan, który zależy od tego, czy została zapisana w bazie danych oraz czy jest aktualnie powiązana z kontekstem persystencji (Persistence Context).
Hibernate wyróżnia cztery podstawowe stany encji:
- Transient – obiekt utworzony w Javie, który nie jest jeszcze zarządzany przez Hibernate.
- Persistent (Managed) – encja powiązana z aktywnym kontekstem persystencji.
- Detached – encja, która była zarządzana przez Hibernate, ale została odłączona od kontekstu persystencji.
- Removed – encja oznaczona do usunięcia z bazy danych.
Transient
Stan Transient oznacza, że obiekt został utworzony w pamięci aplikacji, ale nie jest jeszcze zarządzany przez Hibernate.
User user = new User();
user.setName("Jan");
user.setEmail("jan@example.com");
W powyższym przykładzie obiekt User istnieje wyłącznie w pamięci aplikacji. Hibernate nie śledzi zmian jego stanu i nie wykonuje żadnych operacji na bazie danych.
Aby obiekt przeszedł do stanu Persistent, należy powiązać go z sesją Hibernate, np. za pomocą metody persist().
Persistent (Managed)
Encja znajduje się w stanie Persistent, gdy jest powiązana z kontekstem persystencji zarządzanym przez Session.
try (Session session = sessionFactory.openSession()) {
    Transaction transaction = session.beginTransaction();

    User user = new User();
    user.setName("Jan");

    session.persist(user);

    transaction.commit();
}
Wywołanie session.persist(user) powoduje przejście encji ze stanu Transient do Persistent.
Od tego momentu Hibernate zarządza jej stanem i może automatycznie wykrywać wprowadzone zmiany za pomocą mechanizmu Dirty Checking.
Stan Persistent może również uzyskać encja pobrana z bazy danych:
User user = session.find(User.class, 1L);
Warto pamiętać, że wywołanie persist() nie musi oznaczać natychmiastowego wykonania instrukcji INSERT. Zapis może nastąpić podczas synchronizacji sesji z bazą danych (flush), choć niektóre strategie generowania identyfikatorów, np. IDENTITY, mogą wymagać wcześniejszego wykonania zapytania.
Detached
Encja przechodzi w stan Detached, gdy przestaje być zarządzana przez kontekst persystencji.
Może się to wydarzyć między innymi po zamknięciu sesji lub wywołaniu metody detach().
User user;

try (Session session = sessionFactory.openSession()) {
    user = session.find(User.class, 1L);
}

// Sesja została zamknięta.
// Encja znajduje się w stanie Detached.

user.setName("Adam");
W tym przypadku zmiana nazwy użytkownika nie zostanie automatycznie zapisana w bazie danych, ponieważ encja nie jest już zarządzana przez Hibernate.
Aby ponownie powiązać jej stan z kontekstem persystencji, można wykorzystać metodę merge():
try (Session session = sessionFactory.openSession()) {
    Transaction transaction = session.beginTransaction();

    User managedUser = session.merge(user);

    transaction.commit();
}
Metoda merge() kopiuje stan odłączonego obiektu do encji zarządzanej przez aktualną sesję i zwraca tę zarządzaną instancję.
Ważne: obiekt przekazany do merge() pozostaje w stanie Detached. Nie należy więc zakładać, że user i managedUser reprezentują tę samą instancję w pamięci.
Removed
Stan Removed oznacza, że encja została oznaczona do usunięcia z bazy danych.
W natywnym API Hibernate można wykorzystać metodę remove():
try (Session session = sessionFactory.openSession()) {
    Transaction transaction = session.beginTransaction();

    User user = session.find(User.class, 1L);

    session.remove(user);

    transaction.commit();
}
Po wywołaniu remove() encja zostaje oznaczona do usunięcia. Hibernate wykonuje odpowiednią instrukcję DELETE podczas synchronizacji sesji z bazą danych.
Operacje CRUD w Hibernate
Hibernate umożliwia wykonywanie podstawowych operacji na bazie danych, określanych skrótem CRUD (Create, Read, Update, Delete). Obejmują one tworzenie, odczytywanie, aktualizowanie oraz usuwanie rekordów.
W natywnym API Hibernate operacje te wykonuje się za pomocą interfejsu Session, którego instancje tworzone są przez SessionFactory.
W poniższych przykładach wykorzystam encję User oraz wcześniej skonfigurowany obiekt SessionFactory.
Create – dodawanie nowych rekordów
Do zapisania nowej encji w bazie danych służy metoda persist().
try (Session session = sessionFactory.openSession()) {
    Transaction transaction = session.beginTransaction();

    User user = new User();
    user.setName("Jan");
    user.setEmail("jan@example.com");

    session.persist(user);

    transaction.commit();
}
Wywołanie persist() powoduje objęcie encji zarządzaniem przez Hibernate. Podczas zapisu Hibernate generuje odpowiednią instrukcję SQL:
INSERT INTO users (name, email)
VALUES ('Jan', 'jan@example.com');
Read – pobieranie danych
Do pobierania encji na podstawie ich identyfikatora można wykorzystać metodę find().
try (Session session = sessionFactory.openSession()) {
    User user = session.find(User.class, 1L);

    if (user != null) {
        System.out.println(user.getName());
    }
}
Hibernate generuje zapytanie SQL zbliżone do poniższego:
SELECT id, name, email
FROM users
WHERE id = 1;
Metoda find() zwraca encję o wskazanym identyfikatorze lub null, jeżeli rekord nie istnieje.
Update – aktualizacja danych
Hibernate pozwala aktualizować encje bez konieczności jawnego wywoływania instrukcji UPDATE.
try (Session session = sessionFactory.openSession()) {
    Transaction transaction = session.beginTransaction();

    User user = session.find(User.class, 1L);
    user.setName("Adam");

    transaction.commit();
}
W powyższym przykładzie encja User znajduje się w stanie Persistent, dlatego Hibernate automatycznie monitoruje zmiany jej pól.
Podczas synchronizacji sesji z bazą danych mechanizm Dirty Checking wykrywa zmianę wartości pola name i generuje odpowiednią instrukcję SQL:
UPDATE users
SET name = 'Adam', email = 'jan@example.com'
WHERE id = 1;
Jeżeli chcemy zaktualizować encję znajdującą się w stanie Detached, możemy wykorzystać metodę merge():
try (Session session = sessionFactory.openSession()) {
    Transaction transaction = session.beginTransaction();

    User managedUser = session.merge(detachedUser);

    transaction.commit();
}
Metoda merge() kopiuje stan przekazanego obiektu do encji zarządzanej przez bieżącą sesję. Sam obiekt detachedUser pozostaje odłączony od kontekstu persystencji.
Delete – usuwanie rekordów
Do usuwania encji służy metoda remove().
try (Session session = sessionFactory.openSession()) {
    Transaction transaction = session.beginTransaction();

    User user = session.find(User.class, 1L);

    if (user != null) {
        session.remove(user);
    }

    transaction.commit();
}
Hibernate oznacza encję do usunięcia, a podczas synchronizacji sesji z bazą danych wykonuje odpowiednią instrukcję SQL:
DELETE FROM users
WHERE id = 1;
Operacja usunięcia zostaje trwale zatwierdzona po wykonaniu commit().
Lazy vs Eager Loading
Jednym z najważniejszych mechanizmów Hibernate jest możliwość określenia, kiedy powiązane ze sobą encje powinny zostać pobrane z bazy danych. Odpowiadają za to dwie strategie: Lazy Loading oraz Eager Loading.
Wybór odpowiedniej strategii ma istotny wpływ na wydajność aplikacji, ponieważ decyduje o tym, ile danych Hibernate pobierze podczas wykonywania operacji oraz czy konieczne będzie wykonanie dodatkowych zapytań SQL.
Lazy Loading – leniwe ładowanie danych
Lazy Loading oznacza, że Hibernate nie pobiera powiązanych danych od razu, lecz odkłada ich załadowanie do momentu, w którym aplikacja rzeczywiście będzie ich potrzebować.
Rozważmy przykład relacji OneToMany, w której użytkownik może posiadać wiele zamówień.
@Entity
@Table(name = "users")
public class User {

    @Id
    private Long id;

    private String name;

    @OneToMany(mappedBy = "user", fetch = FetchType.LAZY)
    private List<Order> orders = new ArrayList<>();
}
Pobranie użytkownika za pomocą Session:
try (Session session = sessionFactory.openSession()) {
    User user = session.find(User.class, 1L);

    System.out.println(user.getName());
}
Hibernate wykona zapytanie SQL zbliżone do:
SELECT id, name
FROM users
WHERE id = 1;
W tym momencie pobierane są wyłącznie dane użytkownika. Powiązana kolekcja orders pozostaje niezainicjalizowana.
Dopiero gdy aplikacja spróbuje odczytać zamówienia, Hibernate wykona dodatkowe zapytanie:
try (Session session = sessionFactory.openSession()) {
    User user = session.find(User.class, 1L);

    List<Order> orders = user.getOrders();

    System.out.println(orders.size());
}
Przykładowy SQL:
SELECT id, user_id
FROM orders
WHERE user_id = 1;
Warto zwrócić uwagę, że samo wywołanie getOrders() zazwyczaj nie inicjalizuje kolekcji. Dopiero operacja wymagająca odczytania jej zawartości, np. size(), powoduje pobranie danych.
Hibernate wykorzystuje do tego mechanizm proxy lub specjalne implementacje kolekcji, które pozwalają opóźniać wykonywanie zapytań SQL.
Eager Loading – natychmiastowe ładowanie danych
Eager Loading oznacza, że Hibernate pobiera powiązane encje podczas ładowania encji głównej, niezależnie od tego, czy aplikacja rzeczywiście będzie z nich korzystać.
Aby zastosować tę strategię, wystarczy zmienić parametr fetch:
@OneToMany(mappedBy = "user", fetch = FetchType.EAGER)
private List<Order> orders = new ArrayList<>();
Następnie pobieramy użytkownika:
try (Session session = sessionFactory.openSession()) {
    User user = session.find(User.class, 1L);

    System.out.println(user.getName());
}
Hibernate musi zapewnić dostępność zamówień już podczas pobierania użytkownika. Może to osiągnąć na przykład za pomocą zapytania wykorzystującego JOIN:
SELECT u.id, u.name, o.id, o.user_id
FROM users u
LEFT JOIN orders o ON u.id = o.user_id
WHERE u.id = 1;
Warto jednak podkreślić, że Eager Loading nie oznacza automatycznie wykorzystania JOIN. Hibernate może również wykonać osobne zapytania SQL, aby pobrać powiązane encje. Konkretna strategia zależy od sposobu mapowania i wykonywanego zapytania. docs.hibernate.org
Domyślne strategie pobierania danych
Jeśli nie określimy parametru fetch, Hibernate korzysta z domyślnych wartości zdefiniowanych przez Jakarta Persistence.
| Relacja | Domyślna strategia |
|---|---|
@OneToOne | EAGER |
@ManyToOne | EAGER |
@OneToMany | LAZY |
@ManyToMany | LAZY |
LazyInitializationException – częsty problem przy Lazy Loading
Jednym z najczęstszych problemów związanych z leniwym ładowaniem danych jest wyjątek LazyInitializationException.
Pojawia się on, gdy aplikacja próbuje pobrać niezainicjalizowane dane powiązanej encji, ale sesja Hibernate została już zamknięta.
Przykład:
User user;

try (Session session = sessionFactory.openSession()) {
    user = session.find(User.class, 1L);
}

// Sesja została zamknięta
user.getOrders().size());
W tym przypadku Hibernate pobrał użytkownika, ale nie załadował kolekcji zamówień.
Po zamknięciu sesji próba odczytania kolekcji może zakończyć się wyjątkiem:
org.hibernate.LazyInitializationException:
failed to lazily initialize a collection
Dzieje się tak, ponieważ Hibernate nie posiada już aktywnej sesji, za pomocą której mógłby pobrać brakujące dane.
Rozwiązaniem jest pobranie wymaganych informacji przed zamknięciem sesji. Jedną z możliwości jest jawne zainicjalizowanie kolekcji:
try (Session session = sessionFactory.openSession()) {
    User user = session.find(User.class, 1L);

    Hibernate.initialize(user.getOrders());

    // Kolekcja zamówień została zainicjalizowana
}
Metoda Hibernate.initialize() wymusza inicjalizację wskazanej kolekcji lub proxy. Nie oznacza to jednak, że automatycznie inicjalizowane są wszystkie dalsze relacje obiektów znajdujących się w kolekcji.
Inną, często lepszą metodą jest pobranie potrzebnych danych za pomocą zapytania JOIN FETCH, które to opowiem w później części artykułu.
JPQL, HQL i zapytania natywne SQL
Hibernate umożliwia wykonywanie zapytań do bazy danych na kilka sposobów. Oprócz podstawowych metod, takich jak find() czy persist(), programista może samodzielnie definiować bardziej złożone zapytania, wykorzystując JPQL, HQL lub natywny SQL. Dodatkowo są jeszcze inne możliwości, takie jak NamedQuery czy zapytania poprzez kryteria, ale nie będę ich już tutaj omawiał.
Native SQL – natywne zapytania SQL
Najprostszym sposobem wykonywania operacji SQL jest wykonywanie tradycyjnych zapytań SQL, które odwołują się bezpośrednio do tabel i kolumn w bazie danych.
Do tego celu służy metoda createNativeQuery().
Przykład:
try (Session session = sessionFactory.openSession()) {

    List<User> users = session.createNativeQuery(
        "SELECT * FROM users WHERE name = :name",
        User.class
    )
    .setParameter("name", "Jan")
    .getResultList();
}
W tym przypadku zapytanie operuje bezpośrednio na tabeli users, a nie na encji User.
Dzięki przekazaniu User.class Hibernate może automatycznie przekształcić wynik zapytania na obiekty encji, pod warunkiem że wynik zawiera kolumny niezbędne do jej prawidłowego odwzorowania.
JPQL – Java Persistence Query Language
JPQL (Jakarta Persistence Query Language) to język zapytań zdefiniowany przez specyfikację Jakarta Persistence. Jego składnia przypomina SQL, jednak zamiast bezpośrednio odwoływać się do tabel i kolumn w bazie danych, JPQL operuje na encjach oraz ich polach.
Przykładowo, tradycyjne zapytanie SQL pobierające użytkowników wygląda następująco:
SELECT *
FROM users
WHERE name = 'Jan';
Odpowiednik w JPQL:
SELECT u
FROM User u
WHERE u.name = 'Jan'
Najważniejsze różnice:
Useroznacza nazwę encji Javy, a nie tabeliusers.u.nameodnosi się do pola klasyUser, a nie bezpośrednio do kolumny w bazie danych.- Hibernate na podstawie mapowania encji generuje odpowiednią instrukcję SQL.
HQL – Hibernate Query Language
HQL (Hibernate Query Language) to język zapytań rozwijany przez Hibernate. Jest rozszerzeniem JPQL, co oznacza, że obsługuje standardowe konstrukcje JPQL, ale udostępnia również dodatkowe możliwości charakterystyczne dla Hibernate.
W praktyce większość podstawowych zapytań JPQL jest jednocześnie poprawnymi zapytaniami HQL.
Przykład wykonania zapytania HQL za pomocą natywnego API Hibernate:
try (Session session = sessionFactory.openSession()) {

    List<User> users = session.createSelectionQuery(
        "SELECT u FROM User u WHERE u.name = :name",
        User.class
    )
    .setParameter("name", "Jan")
    .getResultList();
}
W powyższym przykładzie:
createSelectionQuery()– tworzy zapytanie służące do pobierania danych.setParameter()– przekazuje wartość parametruname.getResultList()– wykonuje zapytanie i zwraca listę pasujących encji.
Jakie dodatkowe możliwości oferuje HQL?
W porównaniu ze standardowym JPQL, HQL udostępnia szereg rozszerzeń, między innymi:
- Obsługę bardziej zaawansowanych konstrukcji SQL, w tym CTE (
WITH). - Funkcje okienkowe, takie jak
ROW_NUMBER()czyRANK(). - Rozszerzone możliwości pracy z funkcjami bazodanowymi.
- Dodatkowe konstrukcje zapytań, np. operacje na zbiorach wyników.
Dzięki temu HQL pozwala tworzyć bardziej skomplikowane zapytania bez konieczności bezpośredniego pisania SQL.
JPQL vs HQL vs Native SQL – porównanie
| Kryterium | JPQL | HQL | Native SQL |
|---|---|---|---|
| Operuje na encjach | Tak | Tak | Nie, na tabelach |
| Standard Jakarta Persistence | Tak | Rozszerza standard | Nie |
| Zależność od Hibernate | Nie | Tak | API wykonania – tak |
| Niezależność od bazy danych | Wysoka | Wysoka dla przenośnych konstrukcji | Zależna od SQL |
| Zaawansowane możliwości | Ograniczone do specyfikacji | Rozbudowane | Pełne możliwości SQL danej bazy |
| Mapowanie wyników na encje | Automatyczne | Automatyczne | Możliwe |
Dirty Checking i mechanizm Flush
Hibernate udostępnia mechanizmy umożliwiające automatyczne wykrywanie zmian w encjach oraz synchronizowanie ich stanu z relacyjną bazą danych. Dwa najważniejsze z nich to Dirty Checking oraz Flush.
Dirty Checking – automatyczne wykrywanie zmian
Dirty Checking to mechanizm Hibernate pozwalający automatycznie wykrywać zmiany w encjach znajdujących się w stanie Persistent (Managed).
Gdy Hibernate pobiera encję z bazy danych, umieszcza ją w Persistence Context, dzięki czemu może monitorować zmiany jej stanu.
Rozważmy przykład:
try (Session session = sessionFactory.openSession()) {
    Transaction transaction = session.beginTransaction();

    User user = session.find(User.class, 1L);
    user.setName("Adam");

    transaction.commit();
}
Omawiałem już ten przypadek, gdy opisywałem jak działa UPDATE w Hibernate. Tu warto zapamiętać, że mechanizm odpowiadający za robienie migawki (snapshot) to właśnie Dirty Checing.
Flush – synchronizacja zmian z bazą danych
Flush jest mechanizmem odpowiedzialnym za synchronizowanie stanu Persistence Context z bazą danych.
Podczas działania aplikacji Hibernate może odkładać wykonanie instrukcji INSERT, UPDATE i DELETE, zamiast wysyłać je natychmiast po każdej operacji na encji.
Dopiero w momencie wykonania flush() Hibernate synchronizuje zaplanowane zmiany z bazą danych.
Przykład:
try (Session session = sessionFactory.openSession()) {
    Transaction transaction = session.beginTransaction();

    User user = session.find(User.class, 1L);
    user.setName("Adam");

    session.flush();

    transaction.commit();
}
Po wywołaniu session.flush() Hibernate wykrywa zmodyfikowaną encję i wykonuje odpowiednią instrukcję UPDATE.
Kiedy Hibernate wykonuje Flush?
Hibernate może automatycznie wykonywać flush() w zależności od skonfigurowanego trybu pracy.
Domyślnie wykorzystywany jest tryb AUTO, w którym synchronizacja następuje przede wszystkim:
- Przed zatwierdzeniem transakcji (
commit()). - Przed wykonaniem zapytania HQL, jeżeli jego wyniki mogą zależeć od zmian oczekujących na synchronizację.
- Przed wykonaniem natywnego zapytania SQL bez zarejestrowanej informacji o synchronizowanych encjach lub tabelach.
Problem N+1 w Hibernate
Jednym z najczęstszych problemów wydajnościowych występujących podczas korzystania z Hibernate jest problem N+1 Queries. Polega on na wykonywaniu nadmiernej liczby zapytań SQL podczas pobierania powiązanych ze sobą encji.
Problem pojawia się wtedy, gdy Hibernate wykonuje jedno zapytanie pobierające główne encje, a następnie osobne zapytanie dla każdej z nich w celu załadowania powiązanych danych.
Przykładowo, jeśli aplikacja pobiera 100 użytkowników, a następnie dla każdego użytkownika osobno pobiera jego zamówienia, Hibernate może wykonać aż 101 zapytań SQL:
- 1 zapytanie – pobranie wszystkich użytkowników.
- 100 zapytań – pobranie zamówień poszczególnych użytkowników.
Choć każde zapytanie może być stosunkowo szybkie, duża liczba komunikacji z bazą danych znacząco zwiększa czas wykonania całej operacji.
Rozwiązanie 1. JOIN FETCH
Jednym z najskuteczniejszych sposobów ograniczenia problemu N+1 jest wykorzystanie konstrukcji JOIN FETCH w zapytaniach HQL.
Pozwala ona pobrać encje główne wraz z ich powiązaniami w ramach jednego zapytania SQL.
try (Session session = sessionFactory.openSession()) {

    List<User> users = session.createSelectionQuery(
        """
        SELECT u
        FROM User u
        LEFT JOIN FETCH u.orders
        """,
        User.class
    ).getResultList();

    for (User user : users) {
        System.out.println(
            user.getName() + ": " + user.getOrders().size()
        );
    }
}
W tym przypadku Hibernate generuje zapytanie SQL zbliżone do:
SELECT u.id, u.name, o.id, o.user_id
FROM users u
LEFT JOIN orders o ON u.id = o.user_id;
Rozwiązanie 2. Batch Fetching
Innym sposobem ograniczenia problemu N+1 jest mechanizm Batch Fetching, który pozwala Hibernate pobierać powiązane dane partiami, zamiast wykonywać osobne zapytanie dla każdej encji.
Możemy go skonfigurować za pomocą adnotacji @BatchSize:
import org.hibernate.annotations.BatchSize;

@OneToMany(mappedBy = "user", fetch = FetchType.LAZY)
@BatchSize(size = 20)
private List<Order> orders = new ArrayList<>();
W powyższym przykładzie Hibernate może jednocześnie zainicjalizować kolekcje zamówień maksymalnie 20 użytkowników.
Zamiast wykonywać 20 osobnych zapytań:
SELECT * FROM orders WHERE user_id = 1;
SELECT * FROM orders WHERE user_id = 2;
-- ...
SELECT * FROM orders WHERE user_id = 20;
Hibernate może wykonać jedno zapytanie:
SELECT *
FROM orders
WHERE user_id IN (1, 2, 3, 4, 5, ..., 20);
Pozostałe rozwiązania
Inne sposoby rozwiązanis tego problemu to np.:
- Subselect Fetching
- EntityGraph
Nie będę ich jednak tutaj omawiał.
Cache w Hibernate
Hibernate udostępnia mechanizmy pamięci podręcznej (cache), których głównym zadaniem jest ograniczenie liczby zapytań SQL wykonywanych na bazie danych. Dzięki nim wcześniej pobrane informacje mogą być ponownie wykorzystane bez konieczności każdorazowego odczytywania ich z bazy.
Hibernate wyróżnia dwa podstawowe poziomy pamięci podręcznej:
- First-Level Cache (L1) – pamięć podręczna przypisana do konkretnej sesji Hibernate.
- Second-Level Cache (L2) – pamięć podręczna współdzielona pomiędzy sesjami utworzonymi przez tę samą
SessionFactory.
First-Level Cache
First-Level Cache jest mechanizmem wbudowanym w Hibernate i domyślnie aktywnym w każdej sesji. Stanowi część Persistence Context, który przechowuje i zarządza encjami pobranymi z bazy danych.
Załóżmy, że dwukrotnie pobieramy tego samego użytkownika:
try (Session session = sessionFactory.openSession()) {

    User user1 = session.find(User.class, 1L);
    User user2 = session.find(User.class, 1L);

    System.out.println(user1 == user2); // true
}
Podczas pierwszego wywołania find() Hibernate wykonuje zapytanie SQL i umieszcza pobraną encję w First-Level Cache.
Przy drugim wywołaniu find() Hibernate znajduje encję w pamięci podręcznej i zwraca tę samą instancję obiektu, bez konieczności ponownego odpytywania bazy danych.
First-Level Cache jest przypisany do konkretnej instancji Session. Jeśli otworzymy kolejną sesję, będzie ona posiadała własny, niezależny kontekst persystencji. First-Level Cache nie wymaga dodatkowej konfiguracji, a jego zawartością Hibernate zarządza automatycznie. Programista może jednak ręcznie usuwać encje z kontekstu persystencji za pomocą session.evict(entity) lub wyczyścić cały kontekst przy użyciu session.clear().
Second-Level Cache
Second-Level Cache to mechanizm pozwalający przechowywać dane encji poza kontekstem pojedynczej sesji Hibernate.
W przeciwieństwie do First-Level Cache, pamięć podręczna drugiego poziomu jest współdzielona przez sesje utworzone przez tę samą SessionFactory.
Oznacza to, że encja pobrana w jednej sesji może zostać wykorzystana podczas wykonywania operacji w innej sesji bez konieczności ponownego odczytywania jej danych z bazy.
Second-Level Cache wymaga jednak dodatkowej konfiguracji. Hibernate korzysta z zewnętrznych dostawców pamięci podręcznej, takich jak Ehcache czy Caffeine.
Aby włączyć cache drugiego poziomu dla konkretnej encji, można wykorzystać adnotację @Cache z natywnego API Hibernate:
import jakarta.persistence.Entity;
import jakarta.persistence.Id;
import org.hibernate.annotations.Cache;
import org.hibernate.annotations.CacheConcurrencyStrategy;

@Entity
@Cache(usage = CacheConcurrencyStrategy.READ_WRITE)
public class User {

    @Id
    private Long id;

    private String name;
}
Adnotacja @Cache wskazuje, że encja może być przechowywana w Second-Level Cache, natomiast CacheConcurrencyStrategy.READ_WRITE określa strategię obsługi odczytów i aktualizacji danych w pamięci podręcznej.
Samo dodanie adnotacji nie wystarcza – konieczne jest również skonfigurowanie frameworka cache-ującego.
Strategie Second-Level Cache
Hibernate oferuje kilka strategii zarządzania danymi w pamięci podręcznej:
| Strategia | Charakterystyka |
|---|---|
READ_ONLY | Przeznaczona dla danych, które nie są modyfikowane. |
READ_WRITE | Obsługuje odczyty i aktualizacje z mechanizmem kontroli współbieżnego dostępu. |
NONSTRICT_READ_WRITE | Dopuszcza okresowe odczyty nieaktualnych danych, oferując mniej restrykcyjną synchronizację. |
TRANSACTIONAL | Wykorzystuje dostawcę cache obsługującego transakcyjne zarządzanie danymi. |
Podsumowując, First-Level Cache jest integralną częścią działania Hibernate, natomiast Second-Level Cache stanowi dodatkowy mechanizm optymalizacyjny.
Podsumowanie
Hibernate znacząco upraszcza komunikację aplikacji Java z relacyjnymi bazami danych, eliminując konieczność ręcznego przygotowywania większości podstawowych zapytań SQL. Dzięki mapowaniu obiektowo-relacyjnemu programista może skoncentrować się na pracy z encjami, pozostawiając frameworkowi zarządzanie ich stanem i synchronizację danych.
Efektywne korzystanie z Hibernate wymaga jednak zrozumienia jego wewnętrznych mechanizmów. Szczególnie istotne są strategie pobierania danych, cykl życia encji, Dirty Checking oraz mechanizmy cache. Niewłaściwa konfiguracja może bowiem prowadzić do problemów wydajnościowych, takich jak N+1 Queries.
Warto pamiętać, że Hibernate nie zastępuje znajomości SQL ani zasad działania relacyjnych baz danych. Stanowi natomiast potężne narzędzie, które przy świadomym wykorzystaniu pozwala tworzyć czytelniejsze, łatwiejsze w utrzymaniu i wydajniejsze aplikacje.