
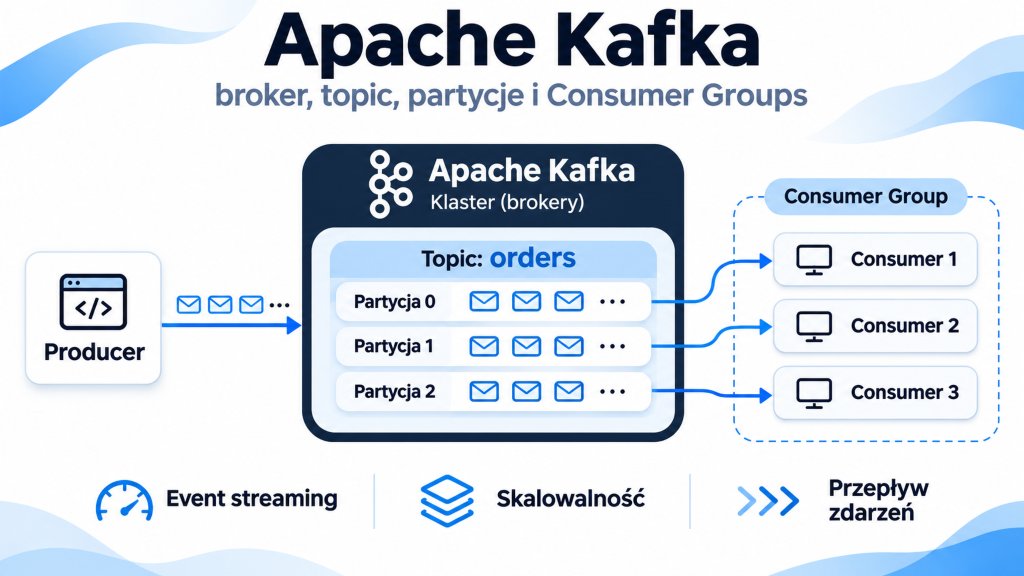
Apache Kafka to jedna z najpopularniejszych platform wykorzystywanych do asynchronicznej komunikacji między aplikacjami oraz przetwarzania strumieni zdarzeń w czasie rzeczywistym. Znajduje zastosowanie szczególnie w architekturze mikroserwisowej i systemach opartych na zdarzeniach (Event-Driven Architecture).
Czym jest Apache Kafka?
Apache Kafka to rozproszona platforma do przesyłania, przechowywania i przetwarzania strumieni zdarzeń (event streaming) w czasie rzeczywistym. Umożliwia komunikację między aplikacjami bez konieczności ich bezpośredniego łączenia.
Kafka jest szczególnie przydatna w systemach rozproszonych, architekturze mikroserwisowej oraz aplikacjach przetwarzających duże ilości danych. Dzięki rozproszonej architekturze zapewnia wysoką przepustowość, skalowalność i odporność na awarie.
W odróżnieniu od tradycyjnych systemów kolejkowych Kafka przechowuje wiadomości przez określony czas, niezależnie od tego, czy zostały już odczytane. Pozwala to wielu aplikacjom niezależnie przetwarzać te same zdarzenia, a w razie potrzeby ponownie je odczytywać. Apache Kafka
Do czego służy Apache Kafka?
Kafka znajduje zastosowanie przede wszystkim w:
- Komunikacji między mikroserwisami – umożliwia asynchroniczną wymianę informacji między niezależnymi aplikacjami.
- Przetwarzaniu zdarzeń w czasie rzeczywistym – pozwala reagować na zdarzenia, np. złożenie zamówienia, wykonanie płatności czy zmianę statusu przesyłki.
- Integracji systemów – umożliwia przesyłanie danych między różnymi aplikacjami i bazami danych.
- Analizie danych – pozwala przetwarzać duże strumienie informacji, np. logi aplikacyjne, transakcje finansowe czy aktywność użytkowników.
Komunikacja asynchroniczna i architektura Event-Driven
W tradycyjnej komunikacji synchronicznej, np. z wykorzystaniem REST API, aplikacja wysyłająca żądanie zazwyczaj oczekuje na odpowiedź drugiego systemu.
Komunikacja synchroniczna polega na tym, że aplikacja wysyłająca żądanie oczekuje na odpowiedź drugiego systemu, zanim będzie mogła kontynuować operację zależną od tej odpowiedzi (np żadanie HTTP). Z kolei komunikacja asynchroniczna jest wtedy, gdy aplikacja wysyła wiadomość, ale nie musi oczekiwać na jej przetworzenie przez odbiorcę, aby kontynuować działanie.
Kafka umożliwia komunikację asynchroniczną, w której aplikacja publikuje zdarzenie, nie czekając na jego przetworzenie przez odbiorców.
Apache Kafka a tradycyjne kolejki wiadomości
Kafka bywa porównywana z brokerami wiadomości, takimi jak RabbitMQ. Chociaż oba rozwiązania umożliwiają komunikację asynchroniczną, różnią się podstawowym modelem działania.
W klasycznych kolejkach RabbitMQ wiadomość po przetworzeniu i potwierdzeniu przez konsumenta jest usuwana z kolejki. Kafka działa inaczej – zapisuje zdarzenia w uporządkowanym dzienniku (log), z którego konsumenci mogą odczytywać dane niezależnie od siebie.
Najważniejsze różnice:
| Cecha | Apache Kafka | RabbitMQ (klasyczne kolejki) |
|---|---|---|
| Główne zastosowanie | Strumienie zdarzeń | Kolejkowanie zadań i wiadomości |
| Przechowywanie | Według polityki retencji | Zwykle do potwierdzenia odbioru |
| Ponowny odczyt | Tak, w okresie retencji | Zwykle nie po potwierdzeniu |
| Odbiorcy | Niezależne grupy konsumentów | Kolejki i subskrypcje |
| Skalowanie | Partycje i Consumer Groups | Kolejki i konsumenci |
Architektura Apache Kafka
Apache Kafka wykorzystuje architekturę opartą na brokerach, topikach, partycjach oraz producentach i konsumentach wiadomości. Aby zrozumieć działanie poszczególnych elementów, wystarczy przykład systemu z jednym brokerem.
Broker i klaster
Broker to serwer Apache Kafka odpowiedzialny za przechowywanie wiadomości oraz obsługę żądań producentów i konsumentów.
Klaster (Cluster) to jeden lub grupa brokerów współpracujących ze sobą jako jeden system. W środowisku produkcyjnym zazwyczaj wykorzystuje się wiele brokerów, co pozwala rozłożyć obciążenie i zwiększyć odporność na awarie.
Przykładowo klaster może składać się z trzech brokerów:
- Broker 1 – przechowuje część wiadomości.
- Broker 2 – przechowuje kolejną część wiadomości.
- Broker 3 – przechowuje pozostałe wiadomości.
Topic i partycja (Partition)
Topic to logiczny kanał, do którego producenci publikują wiadomości, a konsumenci je odczytują.
Przykładowo w systemie e-commerce mogą istnieć następujące topiki:
orders– zdarzenia dotyczące zamówień.payments– zdarzenia dotyczące płatności.notifications– zdarzenia związane z powiadomieniami.
Każdy topic składa się z jednej lub większej liczby partycji (Partitions). Partycja to uporządkowany dziennik, w którym Kafka zapisuje kolejne wiadomości.
Przykładowo topic orders może posiadać dwie partycje:
Kafka Broker
│
└── Topic: orders
    │
    ├── Partition 0: [A] [B] [C]
    │
    └── Partition 1: [D] [E] [F]
Obie partycje znajdują się na tym samym brokerze.
Podział na partycje pozwala przetwarzać wiadomości równolegle. Należy jednak pamiętać, że Kafka gwarantuje kolejność wiadomości w obrębie jednej partycji, a nie całego topicu.
Producer i Consumer
Producer to aplikacja odpowiedzialna za publikowanie wiadomości w określonym topicu.
Podczas wysyłania wiadomości Kafka wybiera partycję, do której zostanie ona zapisana.
Consumer to aplikacja odpowiedzialna za odczytywanie i przetwarzanie wiadomości.
Przykładowo Order Service publikuje zdarzenia w topicu orders, a Notification Service je odczytuje i wysyła powiadomienia.
Jeden broker może obsługiwać wielu producentów i konsumentów jednocześnie.
Consumer Group
Consumer Group to grupa konsumentów współpracujących przy odczytywaniu wiadomości z topicu.
Przykładowo topic orders posiada dwie partycje, a w jednej grupie działają dwa konsumery:
Kafka Broker
│
└── Topic: orders
    │
    ├── Partition 0 ─────> Consumer 1
    │
    └── Partition 1 ─────> Consumer 2

         Consumer Group: orders-group
Każdy konsument odczytuje wiadomości z przypisanej mu partycji, dzięki czemu przetwarzanie może odbywać się równolegle.
W klasycznym modelu Consumer Groups jedna partycja jest przypisana do maksymalnie jednego konsumenta w danej grupie.
Jeśli topic posiada dwie partycje, a grupa składa się z trzech konsumentów, jeden z nich pozostanie bez przydziału.
Istotne jest również to, że różne Consumer Groups mogą niezależnie odczytywać te same wiadomości.
Offset
Offset to numer identyfikujacy, ktory określa pozycję wiadomości dla konkretnej partycji. Każda nowa wiadomość otrzymuje kolejny offset, który pozwala określić jej położenie w dzienniku.
Przykładowo:
Topic: orders

Partition 0:
Offset:      0     1     2
Message:    [A]   [B]   [C]

Partition 1:
Offset:      0     1     2
Message:    [D]   [E]   [F]
Konsumenci wykorzystują offsety do śledzenia postępu odczytu. Kafka umożliwia zapisywanie tego postępu poprzez mechanizm offset commit.
Dzięki temu po ponownym uruchomieniu konsument może wznowić przetwarzanie od zapisanej pozycji.
Co istotne, odczytanie wiadomości nie powoduje jej automatycznego usunięcia z Kafki. Wiadomości pozostają dostępne zgodnie z ustawioną polityką przechowywania danych (retention).
KRaft – zarządzanie klastrem
W starszych wersjach Apache Kafka do zarządzania metadanymi klastra wykorzystywano Apache ZooKeeper.
Od wersji Kafka 4.0 został on zastąpiony przez KRaft (Kafka Raft).
KRaft odpowiada za zarządzanie informacjami dotyczącymi klastra, takimi jak lista brokerów, topików i partycji.
W architekturze KRaft występują dwie role:
- Broker – przechowuje wiadomości i obsługuje producentów oraz konsumentów.
- Controller – zarządza metadanymi klastra.
Jak działa Apache Kafka?
Apache Kafka działa w oparciu o model publish-subscribe, w którym producenci publikują wiadomości w topikach, a konsumenci je odczytują i przetwarzają. W przeciwieństwie do tradycyjnych kolejek wiadomości Kafka nie usuwa zdarzeń po ich odczytaniu, lecz przechowuje je zgodnie z określoną polityką retencji.
Publikowanie i odczytywanie wiadomości
Przykładowo w systemie e-commerce Order Service publikuje zdarzenie OrderCreatedEvent, informujące o utworzeniu nowego zamówienia.
Proces komunikacji wygląda następująco:
- Producer (Order Service) wysyła wiadomość do topicu
orders. - Broker zapisuje wiadomość w jednej z partycji i przypisuje jej offset.
- Consumer (Notification Service) odczytuje wiadomość i wysyła powiadomienie e-mail.
- Po pomyślnym przetworzeniu konsument może zatwierdzić swój postęp poprzez offset commit.
Wybór partycji
Podczas publikowania wiadomości producent może określić jej klucz (key), który wpływa na wybór partycji.
Domyślnie Kafka wykorzystuje funkcję haszującą do przypisania wiadomości z tym samym kluczem do tej samej partycji.
Przykładowo zdarzenia dotyczące zamówienia order-101 mogą trafiać do Partition 0, a zdarzenia dotyczące order-102 do Partition 1.
Dzięki temu wiadomości związane z konkretnym zamówieniem zachowują kolejność w obrębie swojej partycji. Przypisanie może się jednak zmienić po zwiększeniu liczby partycji.
Przechowywanie wiadomości (Retention)
Jedną z najważniejszych cech Apache Kafka jest możliwość przechowywania wiadomości nawet po ich odczytaniu przez konsumentów.
Czas przechowywania określa mechanizm Retention.
Przykładowo, jeśli wiadomości mają być przechowywane przez 7 dni, konfiguracja topicu może wyglądać następująco:
retention.ms=604800000
Oznacza to, że wiadomości mogą być przechowywane przez 7 dni niezależnie od tego, czy zostały wcześniej odczytane. Usuwanie starszych danych odbywa się na poziomie segmentów logu, dlatego nie następuje dokładnie po upływie tego czasu dla każdej pojedynczej wiadomości.
Kafka pozwala również ograniczyć przechowywane dane na podstawie ich rozmiaru, wykorzystując parametr retention.bytes.
Dzięki mechanizmowi retencji konsument może ponownie odczytać wcześniejsze wiadomości, o ile nadal są dostępne w Kafce.
Kolejność wiadomości
Kafka gwarantuje kolejność zapisywania i odczytywania wiadomości w obrębie jednej partycji, ale nie zapewnia globalnej kolejności dla całego topicu.
Przykładowo:
Topic: orders

Partition 0:
Offset 0: OrderCreated(101)
Offset 1: OrderPaid(101)
Offset 2: OrderShipped(101)

Partition 1:
Offset 0: OrderCreated(102)
Offset 1: OrderPaid(102)
Konsument odczytujący Partition 0 otrzyma wiadomości w kolejności ich offsetów.
Nie istnieje jednak gwarancja, że wiadomości z Partition 0 zostaną przetworzone przed wiadomościami z Partition 1.
Z tego powodu przy projektowaniu producentów istotny jest odpowiedni dobór klucza wiadomości.
Replikacja i odporność na awarie
W dotychczasowych przykładach Kafka korzystała z jednego brokera. W środowiskach produkcyjnych często wykorzystuje się kilka brokerów, aby zapewnić większą dostępność danych.
Replikacja polega na przechowywaniu kopii tej samej partycji na różnych brokerach.
Przykładowo dla trzech brokerów i replication.factor=3:
Topic: orders
Partition 0

Broker 1: Leader   [A] [B] [C]
Broker 2: Follower [A] [B] [C]
Broker 3: Follower [A] [B] [C]
- Leader – obsługuje zapisy i standardowe odczyty wiadomości.
- Follower – pobiera dane od lidera i utrzymuje jego replikę.
Jeżeli broker pełniący funkcję lidera ulegnie awarii, Kafka może wybrać nowego lidera spośród zsynchronizowanych replik.
Dzięki temu klaster może kontynuować pracę mimo awarii jednego z brokerów, pod warunkiem odpowiedniej konfiguracji replikacji i dostępności pozostałych elementów klastra.
Warto podkreślić, że nie możesz mieć mniej brokerów niż wartość replication.factor.
Consumer Groups i skalowanie
Jedną z najważniejszych funkcjonalności Apache Kafka jest możliwość równoległego przetwarzania wiadomości przez wielu konsumentów. Mechanizm ten opiera się na Consumer Groups, które pozwalają rozdzielać pracę pomiędzy różne instancje aplikacji.
Czym jest Consumer Group?
Consumer Group to grupa konsumentów współpracujących przy odczytywaniu wiadomości z jednego lub wielu topików.
Każda grupa posiada unikalny identyfikator group.id, a Kafka automatycznie przydziela partycje poszczególnym konsumentom.
Przykładowo topic orders posiada dwie partycje, a grupa notification-group składa się z dwóch konsumentów.
W takim przypadku:
- Consumer 1 odczytuje wiadomości z Partition 0.
- Consumer 2 odczytuje wiadomości z Partition 1.
Dzięki temu obaj konsumenci mogą przetwarzać wiadomości równolegle, nawet jeśli wszystkie partycje znajdują się na jednym brokerze.
Przydzielanie partycji konsumentom
W standardowym modelu Consumer Groups jedna partycja może być przypisana do maksymalnie jednego konsumenta w ramach tej samej grupy.
Nie oznacza to jednak, że każdy konsument może obsługiwać tylko jedną partycję.
Jeśli topic posiada trzy partycje, a grupa składa się z dwóch konsumentów, przykładowy przydział może wyglądać następująco:
Consumer Group: orders-group

Consumer 1:
├── Partition 0
└── Partition 1

Consumer 2:
└── Partition 2
Jeśli natomiast liczba konsumentów przekroczy liczbę partycji, część konsumentów pozostanie bez przydziału.
Z tego powodu liczba partycji określa maksymalny poziom równoległego odczytu w standardowej grupie konsumentów dla pojedynczego topicu.
Wiele Consumer Groups
Kafka umożliwia niezależne odczytywanie tych samych wiadomości przez różne grupy konsumentów.
Przykładowo wiadomości z topicu orders mogą być przetwarzane przez:
notification-group– aplikację wysyłającą powiadomienia.warehouse-group– aplikację odpowiedzialną za przygotowanie zamówień.
Każda grupa odczytuje wiadomości niezależnie i posiada własny zapis postępu przetwarzania (committed offsets).
Oznacza to, że odczytanie wiadomości przez Notification Service nie wpływa na możliwość odczytania jej przez Warehouse Service.
Rebalancing
Rebalancing to proces ponownego przydzielania partycji konsumentom należącym do tej samej Consumer Group.
Może zostać uruchomiony między innymi w sytuacji, gdy:
- Nowy konsument dołączy do grupy.
- Jeden z konsumentów zakończy działanie lub ulegnie awarii.
- Zmieni się liczba partycji w subskrybowanym topicu.
Przykładowo, jeśli grupa posiada dwóch konsumentów i jeden z nich przestanie działać, Kafka może przydzielić jego partycje pozostałemu konsumentowi.
Dzięki temu przetwarzanie wiadomości może być kontynuowane bez konieczności ręcznego zarządzania przydziałem partycji.
Podczas rebalancingu przetwarzanie części partycji może zostać chwilowo wstrzymane. Nowsze protokoły rebalancingu pozwalają ograniczać takie przerwy przez stopniowe przenoszenie partycji między konsumentami.
Skalowanie konsumentów
Apache Kafka umożliwia skalowanie konsumentów poprzez uruchamianie kolejnych instancji aplikacji należących do tej samej Consumer Group.
Przykładowo, jeśli topic orders posiada cztery partycje, można uruchomić czterech konsumentów, z których każdy będzie odczytywał wiadomości z innej partycji.
Pozwala to zwiększyć wydajność przetwarzania bez konieczności modyfikowania logiki producenta.
Warto jednak pamiętać, że dodawanie kolejnych konsumentów nie zwiększy równoległości odczytu, jeśli wszystkie partycje zostały już przydzielone.
Gwarancje dostarczania wiadomości
Apache Kafka oferuje różne modele dostarczania wiadomości, które określają, jak system zachowuje się w przypadku awarii producenta, konsumenta lub brokera.
Wyróżnia się trzy podstawowe modele: at-most-once, at-least-once oraz exactly-once. Aby zrozumieć różnice między nimi, należy najpierw poznać mechanizm commitowania offsetów.
Commitowanie offsetów (Offset Commit)
Jak zostało wcześniej opisane, każda wiadomość w partycji posiada własny numer, nazywany offsetem.
Kafka umożliwia konsumentom zapisywanie postępu przetwarzania wiadomości poprzez mechanizm offset commit.
Przykładowo konsument odczytuje wiadomości z partycji:
Partition 0:

Offset 0: OrderCreated(101)
Offset 1: OrderCreated(102)
Offset 2: OrderCreated(103)
Offset 3: OrderCreated(104)
Jeżeli konsument przetworzył wiadomości o offsetach 0, 1 i 2, może zatwierdzić offset 3, wskazując tym samym kolejną wiadomość do odczytania.
Dzięki temu po ponownym uruchomieniu konsument może wznowić przetwarzanie od zapisanej pozycji.
Kafka umożliwia dwa sposoby commitowania offsetów:
- Automatyczny (Auto Commit) – Kafka Consumer okresowo zatwierdza offsety, jeśli włączono
enable.auto.commit=true. Nie gwarantuje to, że aplikacja zakończyła przetwarzanie wszystkich zatwierdzonych wiadomości. - Manualny (Manual Commit) – aplikacja samodzielnie decyduje, kiedy zatwierdzić offsety, np. po pomyślnym przetworzeniu wiadomości.
Moment zatwierdzenia offsetu ma bezpośredni wpływ na gwarancje dostarczania wiadomości.
At-most-once – co najwyżej jeden raz
W modelu at-most-once wiadomość może zostać przetworzona jeden raz albo wcale.
Aby uzyskać takie zachowanie, konsument może zatwierdzić offset przed rozpoczęciem przetwarzania wiadomości.
Przykładowy scenariusz:
- Konsument pobiera wiadomość
OrderCreated(101). - Zatwierdza offset wskazujący kolejną wiadomość.
- Rozpoczyna przetwarzanie zamówienia.
- Aplikacja ulega awarii przed zakończeniem operacji.
Po ponownym uruchomieniu konsument nie wróci do tej wiadomości, ponieważ jej offset został już zatwierdzony.
Zaleta: brak ponownego przetwarzania tej samej wiadomości w opisanym scenariuszu.
Wada: możliwość utraty wiadomości z punktu widzenia logiki biznesowej.
At-least-once – co najmniej jeden raz
W modelu at-least-once wiadomość powinna zostać przetworzona przynajmniej jeden raz, ale może zostać przetworzona ponownie.
Konsument zatwierdza offset dopiero po pomyślnym przetworzeniu wiadomości.
Przykładowy scenariusz:
- Konsument pobiera wiadomość
OrderCreated(101). - Przetwarza zamówienie i wysyła powiadomienie e-mail.
- Aplikacja ulega awarii przed zatwierdzeniem offsetu.
- Po ponownym uruchomieniu konsument ponownie odczytuje tę samą wiadomość.
- Powiadomienie może zostać wysłane drugi raz.
Zaleta: możliwość ponownego przetworzenia wiadomości po awarii.
Wada: ryzyko wielokrotnego wykonania tej samej operacji.
Dlatego model at-least-once często wymaga stosowania idempotentności, czyli projektowania operacji w taki sposób, aby ich wielokrotne wykonanie nie powodowało niepożądanych skutków.
Przykładowo aplikacja może zapisywać identyfikatory przetworzonych zdarzeń w bazie danych i pomijać ich ponowne przetwarzanie.
Exactly-once – dokładnie jeden raz
Model exactly-once ma zapewniać, że efekt przetwarzania wiadomości zostanie zapisany dokładnie jeden raz, nawet jeśli wystąpią awarie i ponowne próby.
Kafka umożliwia realizację tego modelu za pomocą mechanizmów takich jak:
- Idempotent Producer – zapobiega duplikowaniu wiadomości w Kafce podczas ponawiania zapisu przez producenta.
- Transactions – pozwalają atomowo zapisywać wiadomości do topików oraz zatwierdzać offsety konsumenta.
Przykładowo aplikacja odczytuje zdarzenie OrderCreated(101), przetwarza je i publikuje nowe zdarzenie OrderProcessed(101) w innym topicu.
Dzięki transakcjom Kafka może zagwarantować, że publikacja nowej wiadomości i zatwierdzenie offsetu nastąpią atomowo. W przypadku błędu transakcja zostanie wycofana, a wiadomość źródłowa będzie mogła zostać przetworzona ponownie.
Należy jednak pamiętać, że exactly-once nie oznacza automatycznie jednokrotnego wykonania każdej operacji biznesowej.
Przykładowo zapis do zewnętrznej bazy danych lub wysłanie e-maila wymaga dodatkowych mechanizmów zapewniających idempotentność albo odpowiedniej koordynacji transakcji.
Porównanie gwarancji dostarczania
| Model | Możliwa utrata przetwarzania | Możliwe duplikaty |
|---|---|---|
| At-most-once | Tak | Nie, przy zachowaniu modelu |
| At-least-once | Nie, przy skutecznym ponawianiu | Tak |
| Exactly-once | Nie, w zakresie gwarancji transakcyjnych | Nie w zatwierdzonych efektach transakcji |
W praktyce at-least-once jest często wybieranym modelem przetwarzania wiadomości w Apache Kafka, ponieważ pozwala ograniczyć ryzyko utraty danych, a ewentualne duplikaty można obsłużyć przez idempotentność.
Gwarancje te zależą jednak od poprawnej konfiguracji producentów, konsumentów oraz trwałości danych w klastrze.
Apache Kafka w Spring Boot
Spring Boot umożliwia integrację z Apache Kafka za pomocą biblioteki Spring for Apache Kafka, która upraszcza konfigurację producentów i konsumentów oraz obsługę wiadomości.
Najważniejsze elementy tej integracji to:
KafkaTemplate– służy do publikowania wiadomości w topikach.@KafkaListener– umożliwia odbieranie i przetwarzanie wiadomości.KafkaAdmin– pozwala zarządzać topikami, w tym tworzyć je podczas uruchamiania aplikacji.
Poniższy przykład wykorzystuje Spring Boot 4, Java 21 oraz pojedynczy broker Kafka. Aplikacja będzie publikować zdarzenie OrderCreatedEvent w topicu orders, a następnie odbierać je i przetwarzać.
Dla uproszczenia producent i konsument zostaną umieszczeni w jednej aplikacji. W rzeczywistym systemie mogą stanowić dwa niezależne mikroserwisy.
Uruchomienie Apache Kafka
Najprostszym sposobem uruchomienia lokalnego brokera jest wykorzystanie Dockera:
docker run -d --name kafka \
  -p 9092:9092 \
  apache/kafka:4.1.2
Polecenie uruchamia pojedynczy broker Kafka, dostępny pod adresem localhost:9092. Broker wykorzystuje mechanizm KRaft, dlatego nie wymaga osobnego serwera ZooKeeper. Apache Kafka
Zależności Maven
W Spring Boot 4 integrację z Kafką zapewnia starter spring-boot-starter-kafka:
<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-kafka</artifactId>
</dependency>
Spring Boot automatycznie dobiera kompatybilną wersję biblioteki Spring Kafka i konfiguruje niezbędne komponenty. Security Policy
Konfiguracja połączenia
Połączenie z brokerem oraz ustawienia producenta i konsumenta można skonfigurować w pliku application.yml:
spring:
  kafka:
    bootstrap-servers: localhost:9092

    producer:
      key-serializer: org.apache.kafka.common.serialization.StringSerializer
      value-serializer: org.springframework.kafka.support.serializer.JacksonJsonSerializer
      properties:
        "[spring.json.add.type.headers]": false

    consumer:
      group-id: notification-group
      auto-offset-reset: earliest
      key-deserializer: org.apache.kafka.common.serialization.StringDeserializer
      value-deserializer: org.springframework.kafka.support.serializer.JacksonJsonDeserializer
      properties:
        "[spring.json.use.type.headers]": false
        "[spring.json.value.default.type]": com.example.kafka.OrderCreatedEvent
        "[spring.json.trusted.packages]": com.example.kafka
Najważniejsze parametry:
bootstrap-servers– adres brokera Kafka, z którym aplikacja nawiązuje połączenie.key-serializerivalue-serializer– określają sposób serializacji kluczy i wartości wiadomości.key-deserializerivalue-deserializer– odpowiadają za odtworzenie danych po stronie konsumenta.group-id– identyfikator grupy konsumentów.auto-offset-reset– określa, skąd rozpocząć odczyt, jeżeli grupa nie posiada zapisanego offsetu. Wartośćearliestoznacza rozpoczęcie od najstarszych dostępnych wiadomości.
W przykładzie wykorzystano JacksonJsonSerializer i JacksonJsonDeserializer, które umożliwiają przesyłanie obiektów Java w formacie JSON. Konfiguracja wyłącza przesyłanie informacji o klasie w nagłówkach i wskazuje typ danych po stronie konsumenta.
Tworzenie topicu
Spring Kafka pozwala utworzyć topic podczas uruchamiania aplikacji, wykorzystując bean typu NewTopic:
@Configuration
public class KafkaConfig {

    @Bean
    public NewTopic ordersTopic() {
        return TopicBuilder.name("orders")
                .partitions(2)
                .replicas(1)
                .build();
    }
}
Konfiguracja tworzy topic orders z dwiema partycjami i współczynnikiem replikacji równym 1.
Ponieważ wykorzystywany jest tylko jeden broker, obie partycje będą przechowywane na tym samym serwerze.
Jeśli topic już istnieje, Spring Kafka nie tworzy go ponownie. Security Policy
Wysyłanie wiadomości – KafkaTemplate
Na początku potrzebna jest klasa reprezentująca zdarzenie utworzenia zamówienia:
public record OrderCreatedEvent(Long orderId) {
}
Do publikowania wiadomości służy KafkaTemplate, który Spring Boot automatycznie udostępnia jako bean.
@Service
public class OrderProducer {

    private final KafkaTemplate<String, OrderCreatedEvent> kafkaTemplate;

    public OrderProducer(
            KafkaTemplate<String, OrderCreatedEvent> kafkaTemplate) {
        this.kafkaTemplate = kafkaTemplate;
    }

    public void publish(OrderCreatedEvent event) {
        kafkaTemplate.send(
                "orders",
                event.orderId().toString(),
                event
        );
    }
}
Metoda send() przyjmuje trzy argumenty:
orders– nazwę topicu.event.orderId().toString()– klucz wiadomości.event– obiekt, który zostanie zserializowany do JSON.
Przykładowa wiadomość może wyglądać następująco:
{
  "orderId": 101
}
Metoda send() zwraca CompletableFuture, dlatego potwierdzenie zapisu wiadomości można obsłużyć asynchronicznie.
kafkaTemplate.send("orders", event.orderId().toString(), event)
        .whenComplete((result, exception) -> {
            if (exception != null) {
                System.err.println("Błąd wysyłania: " + exception.getMessage());
            } else {
                System.out.println(
                        "Wiadomość zapisana. Offset: " +
                        result.getRecordMetadata().offset()
                );
            }
        });
Potwierdzenie oznacza zakończenie operacji wysyłania zgodnie z konfiguracją producenta, a nie przetworzenie zdarzenia przez konsumenta. Security Policy
Odbieranie wiadomości – @KafkaListener
Do odczytywania wiadomości Spring Kafka udostępnia adnotację @KafkaListener.
@Component
public class NotificationConsumer {

    @KafkaListener(topics = "orders")
    public void consume(OrderCreatedEvent event) {
        System.out.println(
                "Odebrano zamówienie: " + event.orderId()
        );
    }
}
Spring Kafka automatycznie:
- Tworzy konsumenta należącego do grupy
notification-group. - Subskrybuje topic
orders. - Odczytuje dostępne wiadomości.
- Deserializuje dane JSON do obiektu
OrderCreatedEvent. - Wywołuje metodę
consume().
W przedstawionej konfiguracji Spring Kafka domyślnie zarządza również zatwierdzaniem offsetów. Standardowy tryb BATCH zatwierdza postęp po przetworzeniu rekordów zwróconych przez operację poll(), a niekoniecznie po każdej wiadomości. Security Policy
Uruchomienie przykładu
Aby przetestować komunikację, wystarczy opublikować zdarzenie po uruchomieniu aplikacji:
@SpringBootApplication
public class KafkaDemoApplication {

    public static void main(String[] args) {
        SpringApplication.run(KafkaDemoApplication.class, args);
    }

    @Bean
    ApplicationRunner runner(OrderProducer producer) {
        return args -> {
            producer.publish(new OrderCreatedEvent(101L));
            producer.publish(new OrderCreatedEvent(102L));
        };
    }
}
Po uruchomieniu aplikacji producent wyśle dwie wiadomości do topicu orders, a konsument je odbierze.
W konsoli powinny pojawić się komunikaty podobne do poniższych:
Odebrano zamówienie: 101
Odebrano zamówienie: 102
Warto pamiętać, że Kafka nie gwarantuje globalnej kolejności przetwarzania wiadomości znajdujących się w różnych partycjach.
Równoległe przetwarzanie wiadomości
Jeżeli topic posiada dwie partycje, możliwe jest uruchomienie dwóch konsumentów należących do tej samej grupy.
Spring Kafka pozwala to zrobić za pomocą parametru concurrency:
@KafkaListener(topics = "orders", concurrency = "2")
public void consume(OrderCreatedEvent event) {
    System.out.println("Odebrano: " + event.orderId());
}
W takim przypadku Spring Kafka uruchomi dwa konsumenty w ramach jednej aplikacji.
Każdy z nich może zostać przypisany do osobnej partycji, umożliwiając równoległe przetwarzanie wiadomości bez konieczności uruchamiania kolejnej instancji aplikacji.
Obsługa błędów w Apache Kafka
Podczas przetwarzania wiadomości mogą wystąpić błędy, np. niedostępność bazy danych, problemy z połączeniem z zewnętrznym API lub nieprawidłowe dane.
Spring Kafka udostępnia mechanizmy pozwalające obsługiwać takie sytuacje, w tym Retry (ponawianie przetwarzania) oraz Dead Letter Topic (DLT), do którego można przekierować wiadomości, których nie udało się poprawnie przetworzyć.
Obsługa wyjątków w @KafkaListener
Załóżmy, że konsument odbiera zdarzenia dotyczące nowych zamówień:
@Component
public class NotificationConsumer {

    @KafkaListener(topics = "orders")
    public void consume(OrderCreatedEvent event) {
        if (event.orderId() == 102L) {
            throw new IllegalStateException("Błąd przetwarzania");
        }

        System.out.println("Przetworzono: " + event.orderId());
    }
}
W przypadku zamówienia o identyfikatorze 102 zostanie rzucony wyjątek.
Spring Kafka przechwytuje wyjątki zgłaszane przez @KafkaListener i przekazuje je do mechanizmu obsługi błędów.
Domyślnie wykorzystywany jest DefaultErrorHandler, który pozwala ponawiać przetwarzanie wiadomości. W standardowej konfiguracji wykonuje maksymalnie 10 prób (pierwszą oraz 9 ponowień), a następnie zapisuje informację o niepowodzeniu w logach. Nie przekierowuje automatycznie wiadomości do DLT. Security Policy
Retry – ponawianie przetwarzania
Retry pozwala ponownie przetworzyć wiadomość, jeśli wcześniejsza próba zakończyła się niepowodzeniem.
Spring Kafka umożliwia konfigurację tego mechanizmu przy użyciu DefaultErrorHandler oraz FixedBackOff.
@Configuration
public class KafkaErrorConfig {

    @Bean
    public DefaultErrorHandler errorHandler() {
        return new DefaultErrorHandler(
                new FixedBackOff(1000L, 2L)
        );
    }
}
Konfiguracja oznacza:
1000L– odstęp pomiędzy ponowieniami wynosi 1000 ms.2L– maksymalnie dwie dodatkowe próby przetworzenia.
Łącznie wiadomość może zostać przetworzona trzy razy: jedna próba początkowa i dwa ponowienia.
Jeżeli wszystkie próby zakończą się niepowodzeniem, domyślny handler zapisze błąd w logach i uzna wiadomość za obsłużoną na potrzeby dalszego odczytu.
W Spring Boot wystarczy zarejestrować DefaultErrorHandler jako bean. Zostanie automatycznie powiązany z domyślną fabryką listenerów. Security Policy
Dead Letter Topic (DLT)
W niektórych sytuacjach ponawianie przetwarzania nie rozwiąże problemu. Przykładowo wiadomość może zawierać nieprawidłowe dane, przez co każda kolejna próba zakończy się błędem.
W takim przypadku można wykorzystać Dead Letter Topic (DLT), czyli osobny topic przeznaczony do przechowywania wiadomości, których nie udało się przetworzyć.
Przykładowy przepływ:
Topic: orders
      |
      v
NotificationConsumer
      |
      v
Przetwarzanie wiadomości
      |
      +---- Sukces ----> Zakończenie
      |
      +---- Błąd
              |
              v
         Retry (2 razy)
              |
              +---- Sukces ----> Zakończenie
              |
              +---- Błąd
                      |
                      v
               Topic: orders-dlt
Wiadomości zapisane w DLT mogą następnie zostać przeanalizowane i ponownie przetworzone po usunięciu przyczyny błędu.
Konfiguracja Retry i Dead Letter Topic
Spring Kafka udostępnia klasę DeadLetterPublishingRecoverer, która umożliwia automatyczne publikowanie nieprzetworzonych wiadomości w osobnym topicu.
Poprzednią konfigurację DefaultErrorHandler można rozszerzyć:
@Configuration
public class KafkaErrorConfig {

    @Bean
    public DefaultErrorHandler errorHandler(
            KafkaTemplate<String, OrderCreatedEvent> kafkaTemplate) {

        DeadLetterPublishingRecoverer recoverer =
                new DeadLetterPublishingRecoverer(
                        kafkaTemplate,
                        (record, exception) ->
                                new TopicPartition(
                                        "orders-dlt",
                                        record.partition()
                                )
                );

        return new DefaultErrorHandler(
                recoverer,
                new FixedBackOff(1000L, 2L)
        );
    }
}
W tym przypadku:
- Konsument próbuje przetworzyć wiadomość.
- Jeśli wystąpi błąd, Spring Kafka ponawia przetwarzanie maksymalnie dwa razy.
- Jeżeli wszystkie próby zakończą się niepowodzeniem,
DeadLetterPublishingRecovererpublikuje wiadomość w topicuorders-dlt. - Po udanym przekierowaniu wiadomości konsument może kontynuować odczytywanie kolejnych zdarzeń.
Ponieważ przykład wykorzystuje numer partycji oryginalnej wiadomości, topic orders-dlt również musi posiadać co najmniej dwie partycje.
Można go utworzyć, dodając kolejny bean do istniejącej konfiguracji:
@Bean
public NewTopic ordersDltTopic() {
    return TopicBuilder.name("orders-dlt")
            .partitions(2)
            .replicas(1)
            .build();
}
Odczytywanie wiadomości z DLT
Wiadomości przekierowane do Dead Letter Topic mogą być przetwarzane przez osobnego konsumenta:
@Component
public class DeadLetterConsumer {

    @KafkaListener(
            topics = "orders-dlt",
            groupId = "notification-dlt-group"
    )
    public void consume(OrderCreatedEvent event) {
        System.err.println(
                "Nie udało się przetworzyć zamówienia: "
                + event.orderId()
        );
    }
}
W przedstawionym przykładzie konsument jedynie zapisuje informację o błędzie.
W rzeczywistej aplikacji wiadomości z DLT mogą być wykorzystywane do analizy problemów, monitorowania nieudanych operacji lub ponownego przetwarzania po usunięciu przyczyny awarii.
Warto pamiętać, że wiadomość przekierowana do DLT nie jest automatycznie ponownie przetwarzana przez oryginalnego konsumenta. Wymaga to dodatkowego mechanizmu.
Po wyczerpaniu prób Retry, jeśli DLT nie jest skonfigurowany, domyślny DefaultErrorHandler może zakończyć obsługę błędnej wiadomości jedynie wpisem w logach. Dlatego w systemach produkcyjnych istotne jest odpowiednie skonfigurowanie obsługi błędów, monitorowania oraz przechowywania nieprzetworzonych wiadomości.
Dobre praktyki Apache Kafka
Prawidłowe wykorzystanie Apache Kafka wymaga nie tylko znajomości jej architektury, ale również odpowiedniej konfiguracji producentów, konsumentów i topików. Dobrze zaprojektowany system powinien zapewniać wydajne przetwarzanie wiadomości, odporność na awarie oraz możliwość skalowania.
Dobór liczby partycji
Liczba partycji wpływa na możliwości równoległego przetwarzania wiadomości.
Przykładowo, jeśli topic orders posiada dwie partycje, w standardowym modelu Consumer Groups maksymalnie dwóch konsumentów z tej samej grupy może jednocześnie odczytywać wiadomości z tego topicu.
Zwiększenie liczby partycji umożliwia uruchomienie większej liczby aktywnych konsumentów, ale wiąże się również z większym zużyciem zasobów.
Dlatego liczba partycji powinna być dostosowana do przewidywanego obciążenia i potrzeb skalowania. Zbyt mała może ograniczać wydajność, natomiast zbyt duża niepotrzebnie zwiększać koszty utrzymania klastra.
Właściwy dobór klucza wiadomości
Klucz wiadomości (key) wpływa na wybór partycji, do której Kafka zapisze dane.
Jeżeli wiadomości dotyczą tego samego zamówienia, warto używać identyfikatora zamówienia jako klucza:
kafkaTemplate.send(
    "orders",
    event.orderId().toString(),
    event
);
Dzięki temu wiadomości z tym samym kluczem trafiają do tej samej partycji przy standardowym partycjonowaniu i niezmienionej liczbie partycji.
Pozwala to zachować kolejność zdarzeń dotyczących konkretnego zamówienia, np. OrderCreated, OrderPaid i OrderShipped.
Należy jednak unikać sytuacji, w której większość wiadomości posiada ten sam klucz, ponieważ może to prowadzić do nierównomiernego obciążenia partycji.
Idempotentność przetwarzania
W modelu at-least-once ta sama wiadomość może zostać przetworzona wielokrotnie, np. gdy konsument zakończy działanie przed zatwierdzeniem offsetu.
Dlatego istotne jest projektowanie operacji w sposób idempotentny, czyli zapewniający taki sam efekt końcowy niezależnie od liczby ich powtórzeń.
Przykładowo przed zapisaniem nowego zamówienia aplikacja może sprawdzić, czy zdarzenie o danym identyfikatorze zostało już przetworzone.
W przypadku operacji bazodanowych często wykorzystuje się osobną tabelę przechowującą identyfikatory obsłużonych zdarzeń. Sprawdzenie i zapis identyfikatora powinny odbywać się atomowo wraz z operacją biznesową, np. w jednej transakcji bazodanowej.
Warto również odróżnić idempotentność konsumenta od mechanizmu enable.idempotence producenta. Ten drugi chroni przed duplikowaniem rekordów podczas ponawiania wysyłki przez producenta, ale nie eliminuje wszystkich możliwych duplikatów operacji biznesowych.
Odpowiednia konfiguracja producenta
Producent powinien być skonfigurowany tak, aby ograniczyć ryzyko utraty lub zduplikowania wiadomości.
Przykładowa konfiguracja:
spring:
  kafka:
    producer:
      acks: all
      properties:
        enable.idempotence: true
acks: all– producent oczekuje na potwierdzenie zapisu przez wszystkie wymagane zsynchronizowane repliki.enable.idempotence: true– zapobiega duplikowaniu rekordów podczas ponawiania wysyłania przez tego samego producenta.
W nowoczesnych wersjach Apache Kafka idempotentność producenta jest domyślnie włączona, o ile nie zostaną ustawione sprzeczne z nią parametry. Apache Kafka
Monitorowanie konsumentów
W systemach produkcyjnych istotne jest monitorowanie działania producentów, konsumentów oraz brokerów.
Jednym z najważniejszych wskaźników jest Consumer Lag, określający opóźnienie konsumenta względem najnowszych wiadomości dostępnych w partycji.
Przykładowo:
Partition 0

Najnowszy offset:          1000
Pozycja konsumenta:         850

Consumer Lag:               150
Oznacza to, że konsument ma do nadrobienia około 150 wiadomości.
Rosnąca wartość Consumer Lag może wskazywać, że aplikacja nie nadąża z przetwarzaniem napływających danych.
Do monitorowania Apache Kafka można wykorzystać narzędzia takie jak Prometheus i Grafana, a w aplikacjach Spring Boot również Micrometer. Home
Obsługa błędów i ponawianie przetwarzania
Warto również pamiętać o odpowiedniej konfiguracji mechanizmów Retry oraz Dead Letter Topic (DLT), opisanych w poprzednim rozdziale.
Nie każdy błąd powinien powodować nieograniczone ponawianie przetwarzania. Przykładowo chwilowa niedostępność zewnętrznego API może uzasadniać ponowienie operacji, natomiast nieprawidłowe dane wejściowe mogą wymagać przekierowania wiadomości do DLT.
Istotne jest także monitorowanie liczby wiadomości trafiających do DLT, aby błędy przetwarzania nie pozostawały niezauważone.
Podsumowanie
Apache Kafka to rozproszona platforma do przesyłania i przechowywania strumieni zdarzeń, która umożliwia niezależną komunikację między aplikacjami.
Jej architektura opiera się na brokerach, topikach i partycjach, natomiast mechanizm Consumer Groups pozwala równolegle przetwarzać wiadomości. Dzięki replikacji Kafka może zapewniać wysoką dostępność danych, a mechanizm commitowania offsetów umożliwia konsumentom śledzenie postępu przetwarzania.
Kafka oferuje również różne gwarancje dostarczania wiadomości, takie jak at-most-once, at-least-once i exactly-once. W połączeniu z mechanizmami Retry, Dead Letter Topic oraz odpowiednio zaprojektowaną idempotentnością pozwala budować systemy odporne na błędy.
Integracja ze Spring Boot, wykorzystująca KafkaTemplate i @KafkaListener, upraszcza implementację komunikacji asynchronicznej w aplikacjach Java.
Apache Kafka sprawdza się szczególnie dobrze w systemach wymagających wysokiej przepustowości, skalowalności oraz niezależnego przetwarzania zdarzeń przez wiele aplikacji.
Źródła: